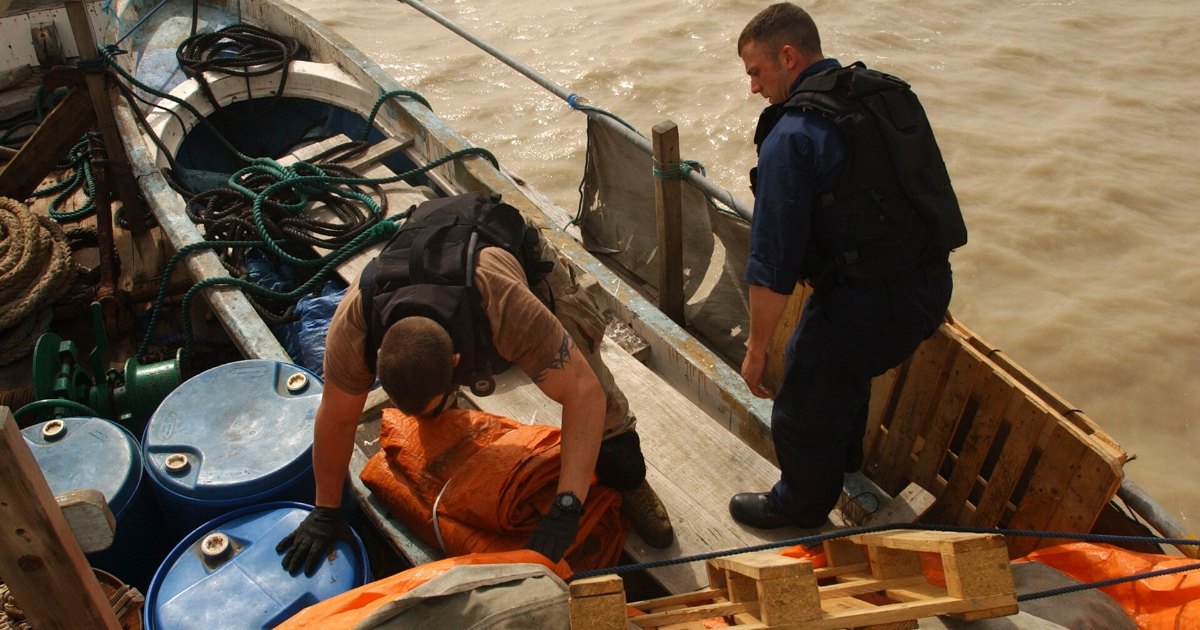
CNN이 9월 18일 미군 안에서 있었던 일을 단독으로 보도했습니다. 올봄 중동에서, 하와이에 있는 미군 태평양특수작전사령부(SOCPAC)에서 나온 정보 보고 하나가 어느 중국 선박에 핵무기 프로그램 부품이 실려 있다고 알렸습니다. 미군이 움직였습니다. 무장 병력이 승선을 준비했고 군용기는 이미 공중에 떠 있었어요. 작전이 시작되기 직전에 관계자들이 그 보고서를 더 깊이 들여다보다가 문서가 AI로 작성됐다는 사실을 발견했습니다. 소스 한 명은 보고서가 "완전히 허위(entirely false)"였다고 했고, 이 일이 "전쟁을 일으킬 뻔했다"고도 말했습니다. 자산은 철수했고 아무도 배에 오르지 않았습니다.
먼저 이 기사의 사정거리부터 밝히는 게 좋겠습니다. CNN은 익명 소스 네 명에 근거해 이 기사를 썼고, 국방부와 SOCPAC은 논평 요청에 답하지 않았습니다. 확인도 반박도 없었다는 뜻이죠. 그래서 공개되지 않은 것이 꽤 많습니다. 분석관이 쓴 챗봇이 상용 제품인지 정부가 만든 제품인지 나오지 않고, 선박에 실제로 무엇이 실려 있었는지도, 사건이 정확히 며칠에 있었는지도 나오지 않습니다.
그런데 공개된 서술 중에 두 번 읽게 되는 대목이 하나 있습니다. 분석관은 챗봇을 두 번 불렀습니다.
▸ 두 번째 호출이 이 사건을 다른 사건으로 만들었습니다
첫 번째 호출에서 분석관은 그 선박의 적하목록에 관해 물었습니다. 챗봇은 공개출처정보와 기밀 신호정보를 결합해 답을 냈고, 화물을 핵무기 프로그램 부품으로 잘못 식별했습니다. 여기까지는 우리가 이미 여러 번 본 장면입니다. 모델이 틀렸고, 사람이 그 답을 받았습니다.
두 번째 호출은 다릅니다. 분석관은 그 결론을 다시 AI에 넣어 표준 정보 보고서 형식으로 포장했습니다. 군 관계자들이 신뢰하는 바로 그 서식으로요. 그리고 그 문서가 유통됐습니다.
서식이 바뀌면 읽는 사람의 자세가 바뀝니다. 채팅창에 뜬 답변은 누가 봐도 모델의 출력이고, 읽는 쪽은 자기도 모르게 한 번 걸러서 받습니다. 그런데 같은 내용이 정보 보고서의 서식을 입으면 그 걸러내기가 사라져요. 그 문서를 받아 든 사람들은 원본이 무엇이었는지 알 방법이 없었습니다. 문서에 그것이 적혀 있지 않았으니까요.
그러니 이 사건을 "AI가 전쟁을 일으킬 뻔했다"로 요약하는 것은 정확하지 않습니다. 모델은 문서를 배포하지 않았고 작전을 발의하지도 않았습니다. 배포한 것은 분석관이고, 멈춘 것도 작전 직전에 보고서를 다시 들여다본 사람입니다. 더 정확한 표현은, 출처가 지워진 생성물이 사람의 검토 단계를 거의 끝까지 통과했다는 것입니다. 그리고 그것을 마지막에 잡아낸 것은 모델의 안전장치도, 정해진 검증 절차도 아니었습니다. 누군가 한 번 더 파고들어 본 것뿐이죠.
▸ 상원이 든 두 번째 사건은 방향이 정반대입니다
이튿날인 9월 19일, 상원의원 세 명이 편지를 보냈습니다. 상원 정보위원회 부위원장인 마크 워너, 군사위원회 간사인 잭 리드, 그리고 크리스 쿤스입니다. 수신인은 피트 헤그세스 국방장관과 제이 클레이턴 국가정보국장이었고요.
세 사람이 요구한 것은 관련 감찰관의 "즉각적인 조사"와 "최종 결론에 대한 더 높은 수준의 공개 투명성"입니다. 감찰관에게 "제한 없는 접근"을 주라고도 했는데, 대상은 올해 언론이 보도한 AI 표적 워크플로 오류 두 건과 아직 공개되지 않은 추가 사례까지입니다. 서한에 적힌 우려는 이렇습니다. 해당 기관들이 "효과적인 거버넌스보다 AI 역량 도입과 '실험'의 가속을 우선해" 왔다는 것이죠.
서한이 함께 든 두 번째 사건은 2월 이란 미나브(Minab)의 학교 오폭입니다. 어린이를 포함해 약 200명이 숨졌습니다. 이란 표적에 관한 정보가 심각하게 낡았다는 경고가 AI 기반 데이터베이스를 포함한 주요 데이터베이스에 떠 있었는데, 지휘부가 그 경고를 지나친 뒤에 벌어진 일이었습니다. 방향이 앞의 사건과 반대죠. 하나는 AI가 만든 것을 믿었고, 하나는 AI가 낸 경고를 믿지 않았습니다. 두 건을 한데 묶어 AI 신뢰성 문제라고 부르는 것도 정확하지는 않습니다. 더 정확한 표현은, 어떤 출력을 어떤 근거로 얼마나 믿을지 미리 정해 둔 규칙이 없었다는 쪽이겠죠.
출처: Wikimedia Commons, David B. Gleason
올해 1월 국방부는 「AI 가속화 전략(Artificial Intelligence Acceleration Strategy)」을 공개했습니다. 네 가지 목표는 내부 실험 장려, 모델 통합을 가로막는 관료적 장벽 제거, 비대칭 우위 분야에 대한 투자 집중, 그리고 일곱 개의 선도 프로젝트 착수입니다. 헤그세스 장관은 "우리는 실험을 촉발하고, 관료적 장벽을 제거하고, 투자를 집중하고, 군사 AI에서 앞서 나가는 데 필요한 실행 방식을 보여 줄 것"이라고 말했습니다. 읽어 보면 도입 속도에 관한 문서입니다. 만들어진 산출물에 무엇을 적어 남길지에 관한 항목은 여기에 보이지 않습니다.
전직 고위 관계자가 CNN에 한 말이 이 대목에서 걸립니다. "내부 도구라는 것들은 대개 상용 제품에 립스틱을 바른 복사본입니다." 그리고 다른 소스는 이렇게 정리했어요. "AI는 나쁜 아이디어에 더 빨리 도달하게 해 줍니다."
▸ 지루한 항목들이 지금 빠져 있는 것입니다
이건 군대만의 문제가 아닙니다. 지금 많은 조직에서 AI가 쓴 장애 보고서와 설계 문서, 리뷰 코멘트가 사람이 쓴 것과 똑같은 서식으로 똑같은 채널에 올라갑니다. 읽는 사람은 구분할 방법이 없고, 대개는 구분하려 하지도 않죠. 검토 단계를 한 칸씩 내려갈수록 그 문서는 그냥 우리 팀이 쓴 문서가 됩니다. (솔직히 저부터도 받아 본 문서에서 그 구분을 해내지 못합니다.)
여기에 필요한 것은 모델을 더 좋은 것으로 바꾸는 일이 아닙니다. 산출물에 생성 여부를 표시하는 필드, 어떤 모델과 어떤 입력으로 만들었는지 남기는 기록, 그 표시를 보고 경로가 갈리는 검토 게이트, 사람이 확인했다는 서명, 그리고 그 전부가 남는 감사 로그입니다. 전부 지루한 항목들이고, 전부 도입 속도를 조금씩 늦추는 것들이에요.
미군의 사례가 보여주는 것은 'AI를 정보 분석에 쓰지 말자'는 결론이라기보다, 생성물이 조직의 공식 서식을 입는 순간 그것을 되짚을 방법도 같이 만들어 두어야 한다는 사실에 가깝습니다. 그럼에도, 우린 절차를 늘려 느려지는 쪽과 늘리지 않아 감수하는 쪽 사이에서 계속 저울질하게 되겠죠. 무엇을 남길지부터 정하는 고민이 필요합니다.
커버 이미지: 북아라비아만에서 화물을 확인하는 미 해군 검문검색(VBSS)팀, 2004년 — Wikimedia Commons, U.S. Navy / Chadwick Vann
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →