원고 722편이 하루 만에 719편이 됐습니다.
OpenAI가 현지시각 10월 6일 저녁 GitHub에 openai/math 저장소를 열었는데요. 공개되지 않은 내부 모델이 생산한 수학 원고 722편이 372개의 결과 묶음(family)으로 정리돼 들어 있었습니다. 라이선스는 Apache 2.0이고, 회사는 기존의 수학 평가에서 성능이 포화돼 미해결 연구 문제로 평가를 확장했다고 설명했습니다. 그리고 다음 날, 세 편이 내려갔습니다.
이유는 부호 하나였습니다. 「Algebraicity of Weil classes on split abelian eightfolds」라는 원고가 어떤 조작을 셀 때마다 부호를 +1로 놓았는데요. 원고 자신이 세워 둔 규약대로 두 갈래가 서로 반대 방향을 향한다는 점을 반영하면 그 자리의 부호는 −1이어야 했습니다. 그래서 0이 되어야 할 값이 0이 되지 않았고, 0일 때만 불러 쓸 수 있는 엘리아시베르크–머피 상쇄 정리를 적용한 단계에서 가정이 충족되지 않았습니다. 그 위에 올려 둔 구성 전체가 근거를 잃었고, 같은 구성을 가져다 쓰던 다른 두 편이 함께 무너졌습니다. 그래서 철회가 한 편이 아니라 세 편입니다.
저장소의 변경 이력(history.md)은 10월 7일 자로 그 경위를 그대로 적어 두었고, 같은 날 다른 14편의 증명이 보수됐으며 그 14편을 인용하던 13편의 참조가 갱신됐습니다. 철회 안내문의 마지막 문장도 적어 둘 만합니다. 이 철회는 증명에 관한 것이지, 그 수학적 명제가 거짓이라고 주장하는 것은 아니라고 돼 있어요.
여기서 형식화라는 말이 무엇을 보증하는지 먼저 고정하고 가는 편이 좋겠습니다. 이 저장소에는 Lean으로 쓴 증명 라이브러리가 함께 들어 있습니다. Lean은 증명 보조 도구(proof assistant)고, 논증의 각 단계를 기계가 한 줄씩 검사합니다. 검사를 통과했다면 그것이 보증하는 것은 하나입니다. Lean 안에 적힌 명제로부터 Lean 안에 적힌 증명이 따라 나온다는 것. 그 명제가 원래의 미해결 문제와 같은 것인지, 그 결과가 새로운 것인지, 중요한 것인지는 보증하지 않습니다. 다만 부호가 뒤집히는 종류의 오류라면 기계가 잡아냅니다. 그게 기계가 가장 잘하는 일이니까요.
철회된 세 편은 거기에 없었습니다. 저장소의 형식화 카탈로그(lean/formalization.yaml)는 스스로를 주 결과가 형식화된 논문의 목록이라고 밝히고 있는데, 공개 당시 첫 커밋의 그 목록 162편 어디에도 Weil 클래스나 Kuga–Satake 대응, K3 곡면 항목은 없습니다. 철회 때문에 빠진 것이 아니라 처음부터 없었다는 뜻이에요. OpenAI가 history.md에 적은 형식화 비율은 719편 가운데 300편, 약 42%입니다. 나머지에 대해서는 README가 직접 이렇게 적어 두었습니다. "형식화되지 않은 결과 가운데 일부에는 문제가 있을 수 있습니다."
▸ 42%는 평평한 숫자가 아닙니다
그런데 42%라는 숫자를 어떻게 읽느냐가 중요합니다. 열 편 중 네 편이 안전하고 여섯 편이 불확실하다는 뜻으로 읽으면, 이번 철회가 왜 한 편이 아니라 세 편이었는지가 설명되지 않거든요. 원고들은 서로 독립된 낱장이 아닙니다. 묶음이라는 단위 자체가 주 결과와 보조 논증, 따름정리, 다른 방식의 증명을 한데 모은 구조고, 원고들은 서로를 인용하며 서로의 구성을 가져다 씁니다. 의존 그래프예요. 그리고 그래프에서 검증은 아래로 전파되지 않습니다. 거꾸로입니다. 검증되지 않은 노드가 상류에 하나 있으면 거기 매달린 것들이 전부 함께 미검증입니다.
테스트 커버리지 42%짜리 코드베이스를 맡아 보신 분이라면 이 구조가 낯설지 않으실 겁니다. 중요한 질문은 남은 58%가 얼마나 큰 숫자인가가 아니라 그 58%가 어디에 있는가입니다. 호출 그래프의 잎사귀 쪽에 몰려 있다면 42%는 꽤 든든한 숫자고, 모두가 지나가는 길목에 하나 박혀 있다면 42%는 사실상 아무것도 보증하지 않습니다. 이번에 뒤집힌 부호는 길목에 있었습니다. 검증의 단위는 원고 한 편이었는데 의존의 단위는 논증 하나였고, 둘이 어긋나 있었던 셈입니다.
42%가 무엇을 세는 숫자인지도 저장소 안에서 한 가지로 읽히지 않습니다. 주 결과가 형식화된 논문의 목록인 lean/formalization.yaml에 지금 올라 있는 논문은 719편 가운데 173편입니다. 42%는 top-line results를 기준으로 한 비율이라고만 적혀 있고, 그 단위가 논문 한 편과 어떻게 다른지는 어디에도 설명돼 있지 않습니다. 둘 다 틀린 숫자는 아닐 겁니다. 다만 밖에서 읽는 사람이 둘을 맞춰 볼 방법이 없습니다.
한 가지는 분명히 해 두는 편이 좋겠습니다. 이 오류를 찾아내 공개한 쪽은 OpenAI입니다. 어느 연산의 부호가 어떻게 뒤집혔는지까지 적어서 올렸고, 철회된 원고에는 무엇이 비었는지 설명하는 안내와 보관된 원본 링크를 붙여 두었습니다. 그러니 이번 일을 AI가 틀린 증명을 썼다는 이야기로 요약하는 것은 정확하지 않습니다. 틀린 증명은 사람도 씁니다. 더 정확한 표현은, 결과가 나오는 속도와 그것을 확인하는 속도가 서로 다른 층에서 움직이고 있고 그 간격을 메울 방법이 아직 합의되지 않았다는 쪽입니다.
▸ 열흘 전 권고문이 요구한 것은 분모였습니다
그 합의를 만들어 보려는 시도가 열흘 전에 있었습니다. 프린스턴 고등연구소(Institute for Advanced Study)에 자리를 둔 수학·인공지능 자문그룹(Advisory Group on Mathematics and Artificial Intelligence)이 9월 29일 「AI가 생성한 수학의 책임 있는 공개」라는 권고문을 냈습니다. 티머시 가워스와 에드워드 위튼을 포함한 아홉 명이 보수 없이 참여했고, 수학계에서 받은 600건이 넘는 설문 응답을 바탕으로 작성됐습니다. 문서는 첫 문단부터 솔직합니다. 우리는 이 관행을 지지하지 않으며, 공개되지 않은 독점 모델로 고난도 수학 문제를 시험하는 일을 멈춰 달라고 요청한다고 적혀 있어요.
권고 가운데 셋이 이번 공개와 정확히 맞물립니다. 결과마다 모델 이름과 사용한 프롬프트, 요약된 사고 과정, 소요 시간, 추정 연산 비용을 공개할 것. 한꺼번에 많은 결과를 낼 때는 별도 문서로 비슷한 난도의 문제 가운데 모델이 시도했다가 풀지 못한 것이 몇 개인지, 그리고 문제를 어떻게 골랐는지를 밝힐 것. 그리고 결과물은 AI 연구소가 통제하지 않는 저장소에, 수정 이력이 남고 가능하면 논문에 댓글을 달 수 있는 곳에 기탁할 것.
OpenAI가 낸 것과 내지 않은 것이 갈립니다. 회사는 결과당 평균 3시간의 ChatGPT Pro 연산을 썼다고 밝혔고, 추론 과정 요약 10건을 공개했고, 모델에게 던진 문제가 약 4,000개였다는 숫자도 적어 두었습니다. 벤더 발표문에서 분모가 나오는 일은 흔치 않으니 이건 적어 둘 만합니다. 반면 모델도 프롬프트도 나오지 않았고, 4,000에서 372까지 오는 동안 무엇이 어떤 기준으로 떨어져 나갔는지에 대한 문서는 없습니다. 저장소는 openai 조직의 GitHub에 있고, Issues 탭은 없으며, 풀 리퀘스트는 협업자만 열 수 있습니다. 고치자고 말할 통로가 발행자 안쪽에만 있다는 뜻이에요.
▸ 힘의 시연이라는 말과 영수증을 요구하자는 말
수학자들의 반응은 갈렸습니다. 인간수학회(Association for Human Mathematics)는 10월 7일 성명을 내고 이번 공개를 "학문의 시연이 아니라 힘의 시연"이라고 불렀습니다. 수학자들이 이 작업을 해 달라고 요청한 적이 없다고 했고, 동료들에게 OpenAI와의 협업을 중단할 것을 촉구했습니다. 이 성명은 테렌스 타오의 블로그에 게스트 포스트로 실렸는데, 타오 본인의 글은 아니고 서명 주체도 개인이 아니라 학회의 커뮤니케이션 워킹그룹입니다. 타오는 하루 전 따로 짧은 글을 올려 'Math 1.0'과 'Math 2.0'을 구분했습니다. 좋아하는 AI 에이전트를 미해결 문제 더미에 겨누는 방식에서 벗어나야 한다는 이야기였고, 풀린 문제는 되돌릴 수 없으니 이런 수확 방식이 분야를 덜 비옥하게 만든다고 했습니다.
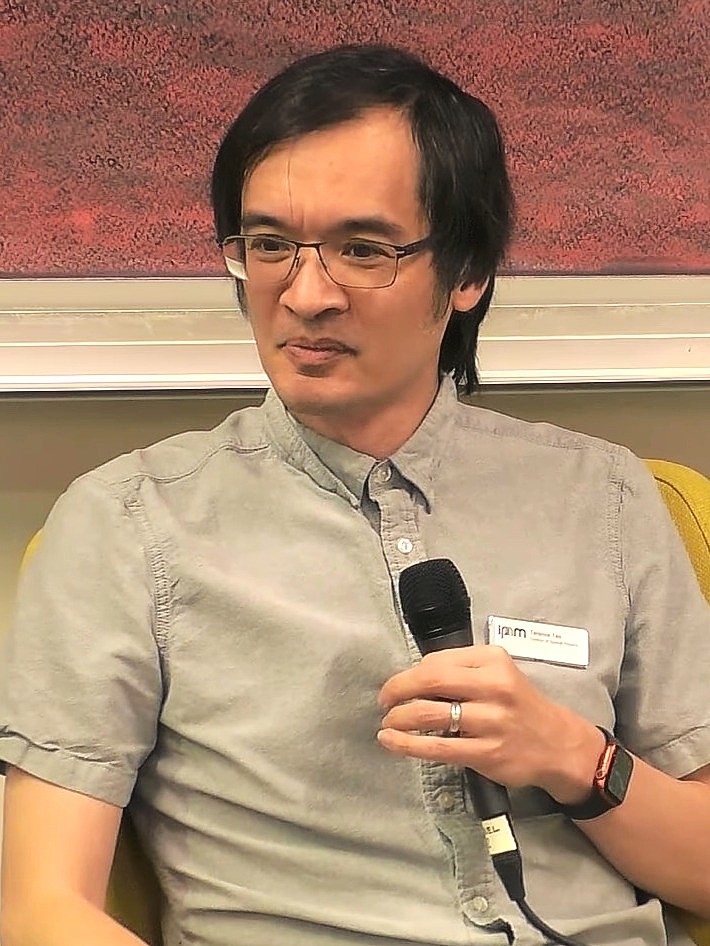
테렌스 타오(UCLA)가 2026년 3월 IPAM의 「AI로 수학과 이론물리 가속하기」 워크숍 좌담에 참석한 모습. 같은 자리에 OpenAI의 마크 첸이 함께 있었습니다. 출처: Wikimedia Commons, IPAM
반대쪽에는 대니얼 릿(토론토대)이 있습니다. 그는 이번 결과가 수학에 좋은 일이라고 했고, 따라가기 어려운 AI 증명에 대한 우려는 과장됐다고 봤어요. 가운데에 가장 가까운 말은 앤드루 서덜랜드(MIT)의 것이었을 텐데요. 단일 프롬프트로 한 번에 풀었다는 주장은 모델이 공개되고 재현될 때까지 미검증으로 취급해야 한다면서, 영수증을 요구해야 한다고 했습니다.
이번 일이 가리키는 것은 AI가 쓴 증명을 믿지 말자는 결론이라기보다, 검증률을 적을 때 몇 퍼센트인지와 함께 어디를 검증했는지도 적어야 한다는 쪽에 가깝습니다. 42%는 그것만으로는 아무 말도 하지 않거든요. 의존 그래프의 어느 자리가 비어 있는지, 그 자리에 무엇이 매달려 있는지가 함께 있어야 비로소 숫자가 됩니다. 이건 수학 원고에만 해당하는 이야기도 아니고요. 그럼에도, 우린 읽어 낼 수 있는 속도보다 빨리 쌓이는 결과와 한 줄씩 따라가야만 생기는 이해 사이에서 계속 갈등하게 됩니다.
커버 이미지: 고등연구소 풀드 홀, 프린스턴 — Wikimedia Commons, Zeete
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →