넷플릭스 기술 블로그가 10월 14일에 자사 GPU 플랫폼을 어떻게 운영하는지 공개했고, InfoQ가 10월 30일 그 내용을 정리했습니다. 숫자는 두 개가 눈에 띕니다. GPU 노드 가용률을 꾸준히 99.95% 위로 유지하고 있고, 잡 성공률은 98% 언저리에서 99.5% 위로 올라갔다고 해요.
숫자만 보면 운영을 잘하고 있다는 자랑 같은데요. 제가 한참 들여다본 건 그 숫자가 아니라, 저 숫자를 만들려고 무엇을 의심해야 했는가 쪽이었습니다.
우리는 보통 장비 장애를 '죽는 것'으로 생각하죠. 클라우드가 기본으로 주는 인스턴스 상태 점검도 그 전제 위에 있습니다. 호스트가 살아 있는지, 운영체제가 응답하는지, 스토리지가 붙어 있는지를 보죠. 전부 초록불이면 그 기계는 일할 준비가 된 것으로 칩니다.
그런데 초록불인 기계가 잡을 망치는 경우가 꽤 있습니다.
왜 그럴까요? 묻는 것과 시켜 보는 것이 다르기 때문입니다.
기본적인 GPU 점검은 드라이버가 응답하는지, GPU가 보이는지 정도를 확인합니다. 드라이버가 들고 있는 장부를 읽는 일이죠. 그런데 워크로드가 실제로 메모리를 크게 할당하거나 연산을 오래 붙들고 있기 시작하면 그제야 어긋나는 카드가 있습니다. 상태를 물으면 정상이라고 답하고, 일을 시키면 틀어지는 겁니다. 네트워크 쪽은 더 교묘한데요. 어댑터는 분명 꽂혀 있고 링크도 올라와 있는데, 올라와 있어야 할 링크 수보다 적게 붙어 있는 경우가 있습니다. 이러면 통신이 끊기지 않습니다. 대역폭만 조용히 깎여 나가죠. 넷플릭스는 이때 잡이 죽는 게 아니라 "기어간다"고 표현했어요.
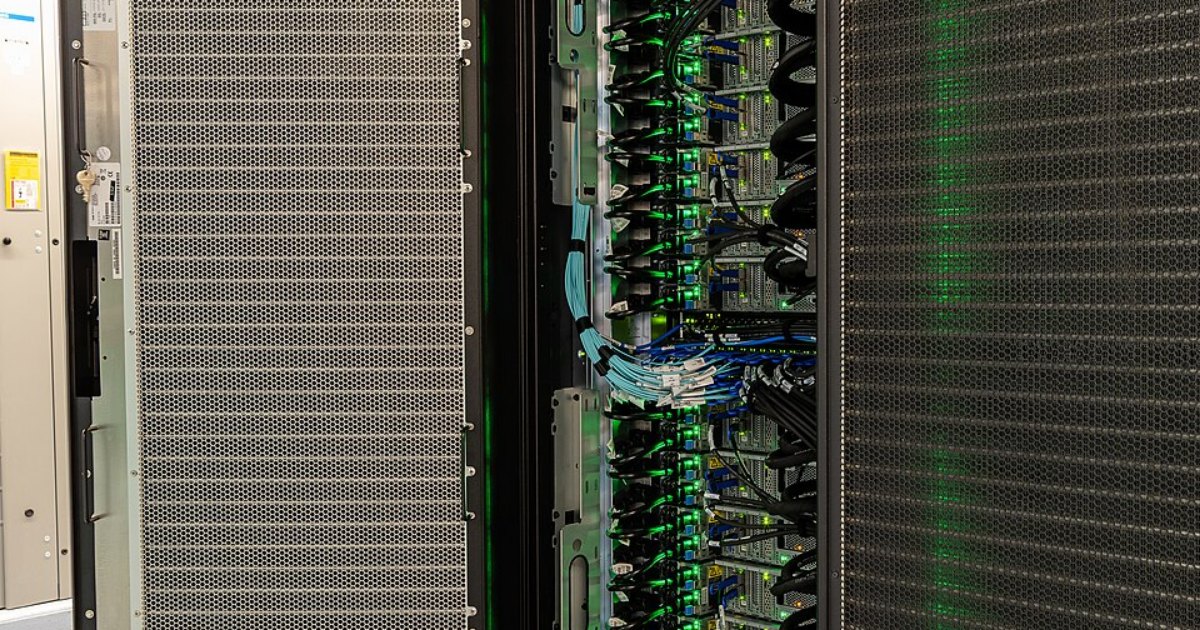
랙 하나를 열면 노드마다 이런 링크 표시등이 줄지어 켜져 있습니다. 불이 켜졌다는 것과 켜져야 할 개수만큼 켜졌다는 것은 다른 이야기죠. 출처: Wikimedia Commons
여기서 중요한 건 '조용히'라는 부분입니다. 예를 들어 GPU 128장으로 모델 하나를 학습시킨다고 가정해 보죠. 매 스텝이 끝날 때마다 128장이 한자리에 모여 각자 계산한 기울기를 합칩니다. 집합 통신(collective communication)이라고 부르는 단계인데요. 모여야만 다음 스텝으로 넘어갈 수 있으니, 가장 늦게 도착한 한 장이 끝날 때까지 나머지 127장은 그냥 기다립니다.
그래서 한 장이 10% 느리면 잡 전체가 10% 가까이 느려집니다. 128분의 1로 희석되지 않아요. 더 곤란한 건 이게 어디에도 오류로 잡히지 않는다는 점입니다. 카드는 죽지 않았고, 통신도 끊기지 않았고, 대시보드는 전부 초록색이죠. 청구서도 평소처럼 나오고요.
넷플릭스가 잡 자체를 분산 시스템으로 다루기로 한 이유가 여기에 있습니다.
기계 한 대를 살았는지 죽었는지로 판정하는 대신, 돌고 있는 잡 안에서 혼자 느린 한 장을 지목합니다. 조치도 한 단계가 아니에요. 처음에는 새 작업만 들어가지 못하게 막고 돌던 잡은 그대로 둡니다. 그래도 증상이 정해 둔 유예 시간을 넘기면 그때 기계를 비우고 교체하죠. 그 사이에 문제가 된 잡만 죽이거나, GPU 한 장만 리셋하거나, 재부팅으로 끝나는 경우도 있고요. 고장이 확정된 카드는 하드웨어 고유 식별자를 따로 기록해 두어서 다시 풀에 들어오지 못하게 합니다.
이 글에서 가장 뜨끔했던 대목은 따로 있었는데요. 어느 업그레이드가 바이너리를 하나 빠뜨리는 바람에, 네트워크 어댑터 개수를 세는 점검이 소리 없이 멈춘 적이 있다고 합니다. 점검이 실패한 게 아니라 아예 돌지 않았어요. 그래서 아무도 경고를 받지 못했고, 어댑터가 모자란 기계가 며칠 동안 그대로 작업을 받았습니다. 지금은 필요한 것이 없으면 점검을 통과가 아니라 실패로 처리한다고 해요. 진단 도구가 응답하지 않으면 타임아웃으로 그 기계를 비정상으로 돌리고요.
점검을 믿으려면 점검이 죽었을 때 무슨 일이 일어나는지부터 정해 두어야 한다는 이야기죠.
여기서부터는 글에 없는 제 생각인데요. 이 글을 읽는 분들 대부분은 GPU를 수천 장 직접 운영하기보다 빌려 쓰실 겁니다. 그런데 넷플릭스가 가용률을 정의한 방식을 다시 보면, 특정 시점에 스케줄할 수 있는 GPU 용량이에요. 이건 빌려주는 쪽이 지키기 좋은 숫자입니다. 할당해 줄 수 있으면 가용한 것이니까요. 반면 빌린 쪽이 알고 싶은 것은 그 시간 동안 잡이 실제로 얼마나 전진했느냐입니다. 청구서는 앞의 숫자를 세고, 손해는 뒤의 숫자에서 나죠. 그래서 죽지는 않고 느려지기만 하는 장비의 비용은 대체로 빌린 쪽이 조용히 떠안게 됩니다. 확인된 사실은 아니고, 구조상 그렇게 되기 쉽다는 가정입니다. 근거라면 넷플릭스조차 가용률과 실제로 전진한 시간을 따로 정의하고, 실패 원인을 하드웨어·드라이버·플랫폼·사용자로 쪼개서 봐야 했다는 점이고요.
그래서 당장 확인해 볼 만한 것은 몇 가지로 좁혀집니다. 우리 헬스체크가 상태를 묻는 수준인지, 메모리를 실제로 할당하고 얼마간 연산을 돌려 보는 수준인지. 진단이 멈췄을 때 기본값이 정상인지 비정상인지. 네트워크 어댑터를 있다 없다로 보는지 링크 개수를 세는지. 잡이 실패했을 때 플랫폼 탓인지 우리 코드 탓인지 먼저 가르고 재시도하는지. 그리고 보고하는 지표가 성공률 하나인지, 잡이 실제로 전진한 시간까지 보는지.
죽은 장비를 찾아내는 일은 그렇게 어렵지 않습니다. 어려운 건 멀쩡한 척하는 장비죠. GPU를 빌려 쓰는 쪽은 앞으로도 계속 늘어날 텐데, 그 어려운 쪽을 누가 보고 있는지는 점점 흐릿해지는 것 같아 좀 걱정이 되네요.
커버 이미지: 오크리지 국립연구소의 서밋 슈퍼컴퓨터 — Wikimedia Commons, Carlos Jones/ORNL
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →