마이크로소프트가 현지시각 10월 12일 OCP Global Summit에서 3세대 자체 AI 가속기 Azure Maia 300을 공개했습니다. 양산과 배포는 2027년부터고, 자사 제품과 서비스의 주된 추론(inference) 시스템을 Maia 제품군으로 만드는 것이 목표라고 밝혔어요.
공개된 수치부터 정리하는 편이 좋겠습니다. 가속기 하나에 HBM4가 여덟 스택 붙어 메모리 용량이 288GB, 대역폭이 18TB/s이고, SoC 기준 설계 전력은 950W입니다. 연산 칩렛은 TSMC의 N2P 공정으로 만들고, 여기에 I/O와 메모리를 맡는 다이를 따로 붙인 멀티 칩렛 구성이에요. 랙 하나에는 가속기 96개가 들어가는데, 랙 전력이 167kW, 랙 전체의 HBM 용량이 27.6TB, 집계 메모리 대역폭이 약 1.7PB/s입니다.
▸ 한 세대를 건너오며 늘어난 것은 연산이 아니라 메모리였습니다
올해 1월에 발표돼 지금 돌아가고 있는 전 세대 Maia 200과 나란히 놓으면 변화의 방향이 분명해집니다. Maia 200은 TSMC 3nm 공정에 HBM3E 216GB, 대역폭 7TB/s, 750W였습니다. 한 세대를 건너오면서 메모리 대역폭은 2.5배가 됐고 용량은 33% 늘었는데, 전력은 27% 오르는 데 그쳤습니다. 늘어난 전력 예산의 상당 부분이 연산이 아니라 메모리 쪽으로 갔다는 뜻이죠.
왜 메모리인지는 추론이 돌아가는 방식을 떠올리면 수긍이 갑니다. 토큰 하나를 만들 때마다 모델 가중치를 메모리에서 읽어 와야 하고, 대화가 길어질수록 앞서 계산해 둔 KV 캐시도 같이 커집니다. 에이전트처럼 도구를 여러 번 호출하며 맥락을 쌓아 가는 작업이라면 그 부담은 더 빨리 불어나고요. 연산 장치를 아무리 빠르게 만들어도 읽어 올 데이터가 제때 도착하지 않으면 그 장치는 기다리고 있을 뿐인데, 기다리는 동안에도 전기는 똑같이 씁니다.
마이크로소프트 자신도 그렇게 설명합니다. 마이크로소프트 블로그는 "대규모 추론 시스템에서 병목은 점차 연산 능력이 아니라 데이터를 효율적으로 옮기는 것"이라고 적었어요. 스케일업 네트워크도 그 설명에 맞춰 설계돼 있습니다. 가속기마다 온다이 네트워크 컨트롤러가 들어가고 400Gb/s 이더넷 포트 32개로 양방향 3.2TB/s를 냅니다. 온다이 SRAM은 소프트웨어가 직접 관리하는 스크래치패드로 열어 두었는데, 커널이 HBM까지 내려가지 않고 버틸 수 있는 만큼 버티라는 설계입니다. 강화된 MXFP4 같은 저정밀 포맷을 지원하는 이유도 같은 자리에 있습니다. 토큰 하나를 만들 때 옮겨야 하는 바이트 수를 줄이면 KV 캐시가 차지하는 메모리가 줄고, 그만큼 긴 컨텍스트를 감당할 수 있거든요.
▸ 분모가 와트로 바뀌었습니다 : 그런데 비교 대상은 적혀 있지 않습니다
그런데 이번 발표에서 제가 가장 오래 들여다본 것은 사양표가 아니라 성능을 말하는 단위였습니다. 마이크로소프트는 Maia 300이 "선도적인 GPU 기반 시스템 대비 메가와트당 토큰을 약 40% 더 뽑아낼 것으로 기대한다"고 했습니다. 측정치가 아니라 2027년에 나올 칩에 대한 기대치입니다. 분모가 와트입니다. 몇 해 전만 해도 가속기 발표의 첫 줄은 연산 성능이었고 전력은 각주에 가까웠는데요. 이제는 순서가 뒤집혔습니다. 공개된 연산 성능도 가속기당 FP4에서 13.8 POPS, FP8에서 6.9 POPS인데, FP16이나 BF16 수치는 아예 내놓지 않았습니다. 학습에서 주로 쓰는 정밀도의 수치는 빼고, 추론에서 쓰는 저정밀도 수치만 적어 둔 겁니다. 학습에서는 엔비디아가 여전히 핵심 파트너라는 점과 같이 놓고 보면 일관된 선택이에요.
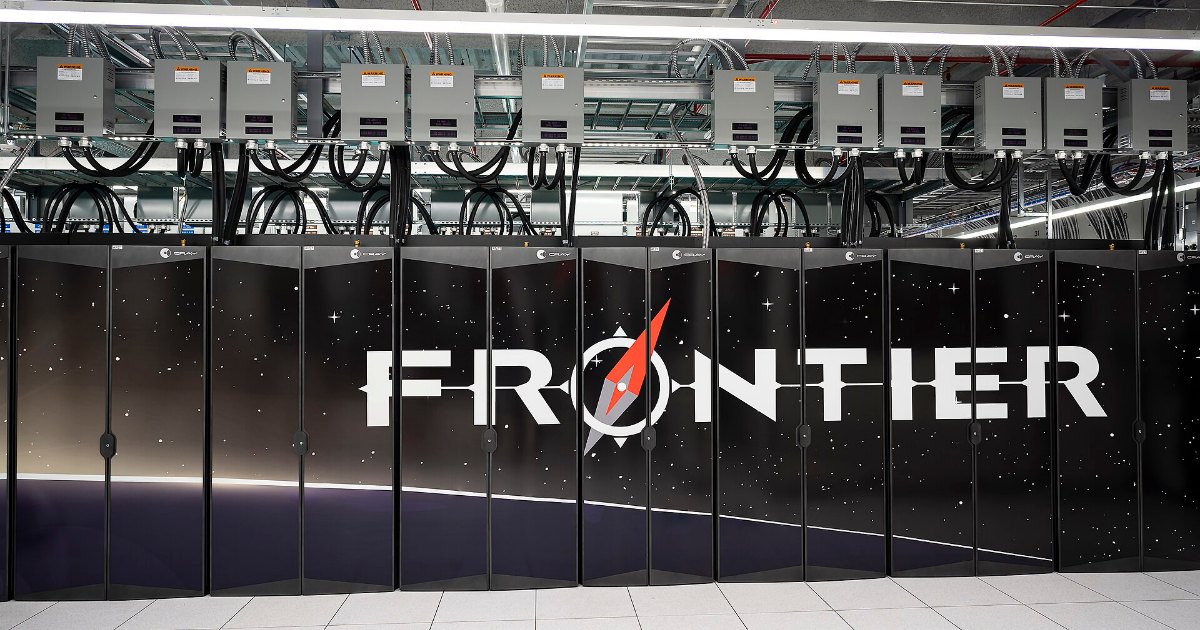
캐비닛마다 천장에서 전원 차단기와 굵은 전력 케이블이 따로 내려옵니다. 랙 하나가 전기를 얼마나 먹느냐가 설계의 출발점이 된 기계인데, Maia 300의 랙은 167kW입니다. 출처: Wikimedia Commons, Oak Ridge National Laboratory
그 40%에는 비교 대상이 적혀 있지 않습니다. 어떤 GPU인지, 어떤 모델인지, 어떤 서빙 구성인지 셋 다 공개되지 않았고 제3자가 측정한 결과도 아직 없습니다. 더 눈여겨볼 것은 앞으로도 쉽지 않다는 점인데요. Maia는 지금까지 Azure에서 빌릴 수 있는 인스턴스로 제공된 적이 없습니다. 마이크로소프트 내부에서 도는 칩이에요.
▸ 빌릴 수 없는 칩 : 성적표가 벤치마크가 아니라 매출원가에 적힙니다
그래서 이번 발표를 "엔비디아의 경쟁 제품이 또 하나 나왔다"로 읽으면 초점이 조금 어긋납니다. Maia 300은 시장에서 벤치마크로 이겨야 하는 상품이 아니라, 마이크로소프트가 Copilot과 Teams를 비롯한 자사 서비스의 추론 원가를 낮추려고 만든 설비에 가깝습니다. 성공의 기준도 다르죠. 같은 전력으로 토큰을 더 많이 만들어 내면 그것으로 제 몫을 한 것이고, 그 결과는 외부 벤치마크 표가 아니라 마이크로소프트의 매출원가에 적힙니다. 물론 비교 대상을 적지 않은 것이 검증을 피하려는 의도라고 단정할 수는 없습니다. 더 정확한 표현은, 이 칩에는 비교 수치를 따져 물을 외부 고객이 아직 없다는 것입니다. 마이크로소프트는 11월 Ignite에서 상세를 더 공개하겠다고 했으니 그때 확인할 수 있는 범위가 조금 넓어질 수는 있겠습니다.
한 가지만 더 짚겠습니다. 가속기 하나에 HBM4가 여덟 스택, 랙 하나에 27.6TB입니다. 2027년부터 멀티 기가와트 규모로 깔겠다는 계획이 그대로 간다면 메모리 수요가 상당할 텐데, Maia 300의 HBM4를 누가 공급하는지는 이번 발표에 나오지 않았습니다. 전 세대인 Maia 200의 HBM3E는 SK하이닉스가 단독으로 공급한다는 보도가 올해 1월에 있었고요. 추론용 가속기가 연산보다 메모리로 세대를 넘는 흐름이 이어진다면, 그 흐름에서 값이 매겨지는 부품이 어디에 있는지는 분명합니다.
쓰는 쪽에서 따져볼 숫자도 같이 바뀝니다. 모델을 고를 때 들여다보던 것이 파라미터 수와 벤치마크 점수였다면, 실제 청구서를 결정하는 것은 평균 컨텍스트 길이, KV 캐시가 차지하는 메모리, 배치 크기, 토큰당 지연시간 같은 것들이죠. 공급하는 쪽이 성능을 메가와트당 토큰으로 말하기 시작했다면 그 분모가 결국 어느 단계에서 우리 쪽으로 넘어오는지, 한 번쯤 고민이 필요합니다.
커버 이미지: 마이크로소프트 데이터센터(네덜란드 미던메이르) — Wikimedia Commons, Hay Kranen
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →