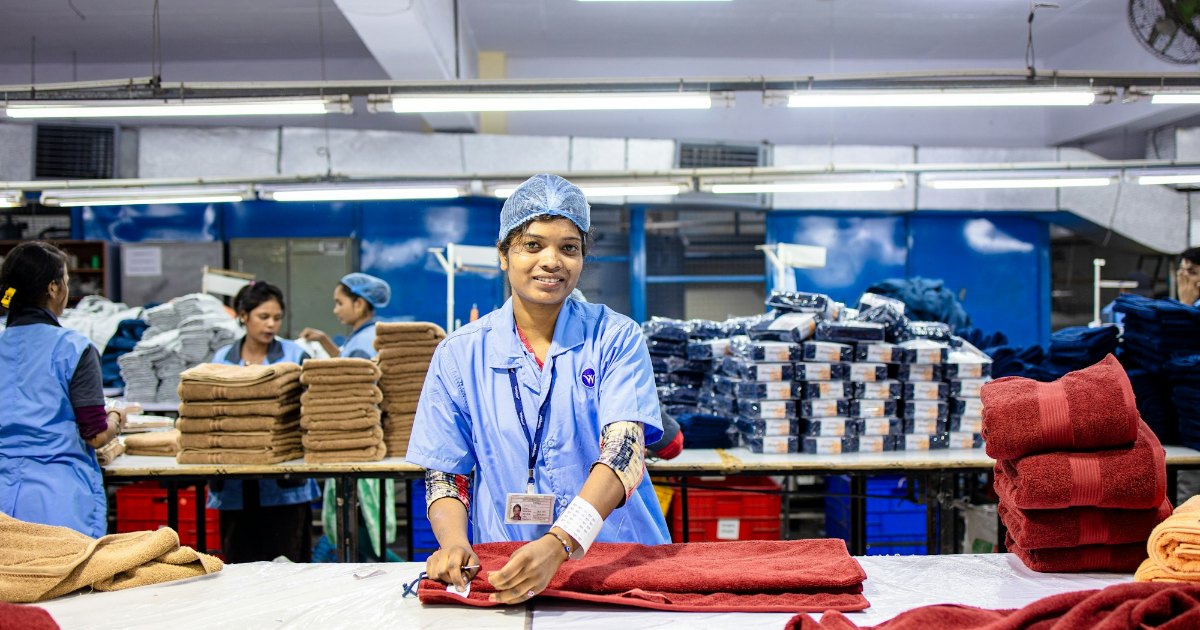
인도 남부 타밀나두주에 카루르(Karur)라는 도시가 있습니다. 섬유 산업으로 먹고사는 곳인데요. 그곳의 한 공장에서 여성 노동자들이 앞치마를 접어 포장합니다. 10년째 같은 자리에서 같은 일을 하는 사람도 있고요. 달라진 것은 하나뿐입니다. 머리에 고프로가 달려 있습니다.
NPR이 10월 14일 이 공장을 취재해 내보냈습니다. 카메라를 나눠 준 곳은 같은 도시의 데이터 기업 Objectways이고, 모인 영상은 AI 개발사에 팔립니다. 용도는 로봇 학습이에요. 업계에서는 이런 영상을 에고센트릭 데이터(egocentric data), 그러니까 사람의 눈높이에서 찍은 1인칭 영상이라고 부릅니다. 인도과학원의 프라토시 A.P. 교수는 지금의 AI를 몸 없는 뇌로 생각하면 된다고 설명했습니다.
그런데 걸리는 게 하나 있습니다. 유튜브에는 양파 써는 영상이 이미 수백만 개 올라와 있습니다. 왜 굳이 공장까지 찾아가서 새로 찍을까요.
답은 영상 안에 없는 것에 있습니다. 로봇을 움직이는 프로그램, 정책(policy)이라고 부르는 것은 결국 함수 하나입니다. 지금 보이는 장면을 입력으로 받아 다음 행동을 출력하죠. 여기서 행동은 손을 든다 같은 말이 아니라, 각 관절을 몇 도로 돌리고 집게를 얼마나 벌릴지에 해당하는 숫자입니다. 그런데 영상에는 그 숫자가 없습니다. 픽셀은 세상이 어떻게 보였는지만 알려줄 뿐, 어떤 명령이 그 변화를 만들어 냈는지는 알려주지 않거든요. 풀어야 할 문제만 잔뜩 있고 정답지는 없는 셈인데요. 로봇 학습 논문들이 공통으로 첫 번째 병목으로 꼽는 것이 바로 이겁니다.
1인칭 카메라는 그 정답지를 만들어 내려는 장치입니다. 카메라가 사람 몸에 붙어 있으면, 화면 속 배경이 흘러가는 모양만 보고도 카메라가 공간에서 어떻게 움직였는지를 거꾸로 계산할 수 있습니다. 지나온 풍경만으로 내가 어느 길로 왔는지 되짚는 것과 비슷하죠. 그렇게 카메라의 위치를 복원하고 그 위에서 손의 3차원 궤적을 뽑아내면, 비로소 이 장면일 때 손이 여기로 갔다는 짝이 생깁니다. 다만 머리에 쓴 카메라는 기준점 자체가 같이 흔들리기 때문에, 좌표계를 먼저 고정하는 작업이 앞에 들어갑니다. (벽에 고정한 카메라로 찍으면 이 고생을 안 해도 되지만, 그러면 손이 몸에 가려 안 보이는 순간이 너무 많습니다.)
문제가 하나 더 남습니다. 사람 손과 로봇 팔은 닮지 않았습니다. 손가락 다섯 개에 관절이 스무 개 넘게 달린 손과, 벌렸다 오므리는 동작 하나가 전부인 집게는 생긴 것도 다르고 움직이는 방식도 다릅니다. 연구자들이 임바디먼트 갭(embodiment gap)이라고 부르는 간극인데요. 뉴욕대 러렐 핀토 교수 연구실이 내놓은 EgoZero는 이걸 피하려고 영상 자체를 학습시키지 않습니다. 손과 물체 위의 점 몇 개만 3차원으로 추적해서, 그 좌표만 로봇 쪽으로 옮겨 놓죠. 사람 손 사진과 로봇 팔 사진이 너무 달라서 그림을 그대로 보여주면 오히려 방해가 되기 때문이에요. 실제로 같은 과제를 이미지로 학습시킨 비교군은 한 번도 성공하지 못했습니다. 스마트글라스로 과제당 20분씩 일곱 가지를 찍었고, 로봇으로 수집한 데이터는 한 건도 쓰지 않은 채 성공률 70%를 냈습니다.
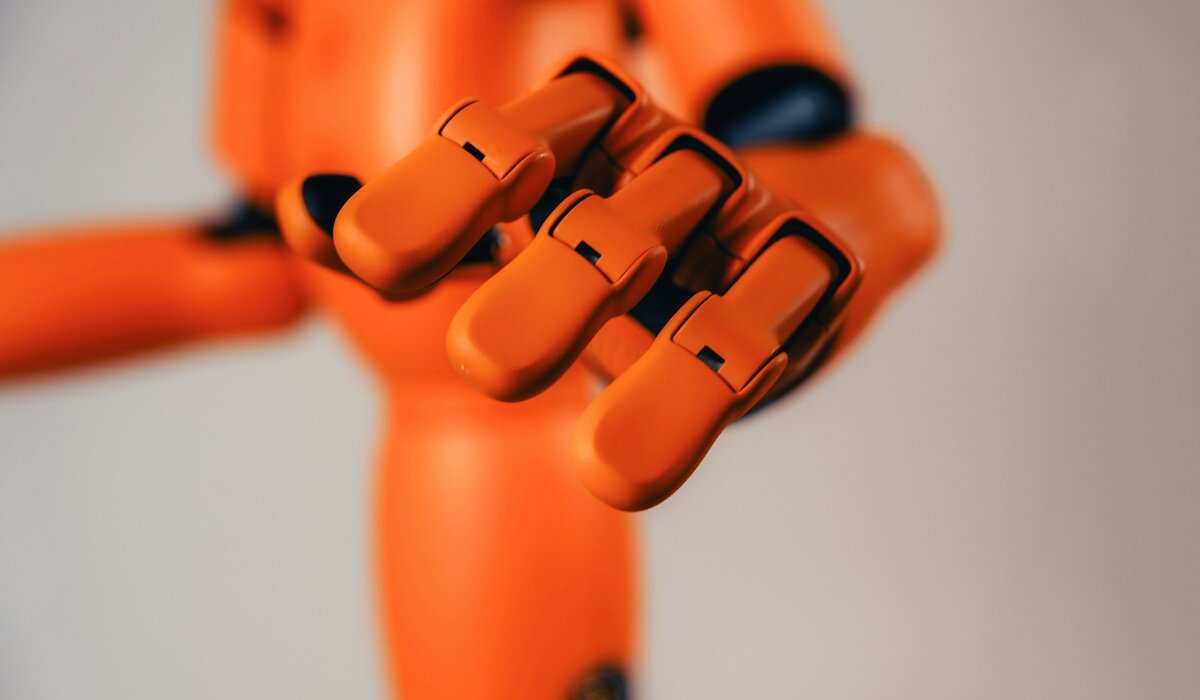
사람 손을 닮게 만든 축에 드는 로봇 손인데도 손가락 수부터 다릅니다. 공장에서 실제로 쓰는 평행 집게라면 차이는 더 벌어지고요. 출처: Unsplash, Enchanted Tools
여기까지 오면 카루르에서 가장 이상해 보이던 장면이 설명됩니다. Objectways의 작업자들은 맨손이 아니라 로봇 집게를 닮은 도구를 쥐고 병뚜껑을 잠갔다 여는 동작을 백 번쯤 반복합니다. 사람 손을 찍어 두고 나중에 로봇 손으로 번역하는 대신, 아예 로봇의 손을 사람에게 먼저 끼워 버린 겁니다. 기록되는 순간부터 로봇이 따라 할 수 있는 형태로 남으니까요. 백 번씩 반복하는 이유를 회사 쪽은 로봇이 물병을 알아보게 하려는 것이라고 설명했는데요. 여기에는 이유가 하나 더 있습니다. 뚜껑 하나를 여는 정답이 아니라, 뚜껑이 어디에 어떻게 놓여 있든 여는 방법이 필요하거든요.
저는 이 데이터가 앞선 것들과 성격이 다르다는 점이 계속 마음에 남습니다. 언어 모델이 먹은 텍스트도, 이미지 모델이 먹은 사진도 이미 세상에 쌓여 있던 것을 긁어모은 것이었습니다. 그런데 손의 궤적은 어디에도 쌓여 있지 않습니다. 누군가 몸으로 해 보여야 그 순간 생깁니다. 크롤러로는 모을 수 없는 첫 번째 학습 데이터인 셈이죠. 예측은 아니고 가정입니다만, 그렇다면 이 분야의 원가 바닥은 GPU 시간이 아니라 사람 시간에 걸립니다. 개발사들이 필요하다고 말하는 분량이 수백만 시간 단위라는 점, 그리고 모집 장소가 임금이 낮은 곳이라는 점이 그 가정과 맞아떨어지고요.
임금 쪽 숫자를 보면 그 가정이 조금 더 또렷해집니다. 10년을 일한 섬유공장 노동자의 월급이 90달러인데, 촬영에 붙는 보수는 시간당 2.6달러예요. 하루 몇 시간씩 집안일을 찍는 24세 참여자는 그렇게 월 120달러를 법니다. 그러니 공장 일보다 촬영이 낫다는 계산이 서기도 하는데요. 그런데 10년차 노동자는 자기 영상이 어디에 쓰이는지 들은 적이 없다고 했습니다. 올해 4월에도 헤드셋을 쓴 노동자들이 줄지어 앉은 영상이 퍼지며 인도에서 한 차례 소란이 있었습니다. 한 뉴스 앵커는 이건 SF 영화의 한 장면이 아니라고 말했고요. Aapti Institute의 아스타 카푸어 공동창업자는 이것을 노동 착취라고 불러야 한다면서, 사람은 로봇보다 돌리는 비용이 싸다고 덧붙였습니다. 카메라를 나눠 준 쪽도 비용 판단은 같습니다. Objectways의 라비 샹카르 CEO 역시 로봇이 사람 인건비보다 싸질 것 같지는 않다고 봤어요. 두 사람이 갈리는 건 가격이 아니라 이렇게 모은 영상을 뭐라고 부를 것인가죠. 촬영에 참여한 42세 노동자는 자기가 로봇에게 제대로 하는 법을 가르칠 수 있어 뿌듯하다고 했습니다.
기계에 손을 달아 주는 일이 결국 사람 손을 빌려야만 되는 일이라는 게 묘하게 읽히네요. 적어도 빌릴 때는 어디에 쓸 것인지 말해 주고 빌렸으면 싶습니다.
커버 이미지: 인도의 섬유공장에서 수건을 개는 노동자 — Unsplash, EqualStock
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →