매출총이익률이 50%에서 마이너스 50%로 내려가는 데 다섯 달이 걸렸습니다. 회사가 흔들려서 그렇게 된 것이 아니었어요. 제품이 잘돼서 그렇게 됐습니다.
블룸버그가 현지시간 21일 법률 AI 회사 하비(Harvey)의 사정을 보도했습니다. 하비의 매출총이익률은 올해 초 약 50%였는데 6월에 약 -50%까지 떨어졌다고 합니다. 원인으로 지목된 것은 3월에 내놓은 에이전트 업데이트예요. 고객이 쓰기 시작했고, 많이 썼고, 올해 들어 토큰 사용량이 스무 배로 늘었습니다. OpenAI와 앤트로픽의 기업 고객 과금은 사용량 기반이니, 그 스무 배가 그대로 원가로 넘어왔고요.
먼저 이 숫자의 사정거리부터 밝히는 게 좋겠습니다. 이 이익률은 하비가 공개한 숫자가 아니라 블룸버그 보도로 전해진 숫자입니다. 하비는 비상장사라 재무를 공시하지 않고, 회사가 공개한 블로그에도 이익률은 나오지 않아요. 아래 이야기는 그 수치가 대체로 맞다는 전제 위에 서 있습니다.
배경을 조금 보태면, 하비는 지금 어려운 회사가 아닙니다. 9월 9일 5억 5,000만 달러를 조달하면서 기업가치를 약 156억 달러로 인정받았고(매체에 따라 155억 달러로 적히기도 합니다), 연간반복매출은 4억 달러를 넘겼습니다. 고객 조직이 3,000곳을 넘고, 미국 대형 로펌 순위인 Am Law 100의 80%가 하비를 씁니다. 그렇게 잘되는 회사의 매출총이익률이 한때 마이너스 50%였다는 뜻이죠.
▸ 원가가 된 생각 : 사용량이 늘수록 손해가 커지는 구조
소프트웨어 회사의 손익을 읽던 예전 방식으로는 이 조합이 잘 설명되지 않습니다. 좌석 단위로 파는 SaaS에서 고객이 화면을 한 번 더 열어 보는 비용은 사실상 0이었어요. 사용량이 늘면 매출은 늘고 원가는 거의 그대로였으니, 규모가 커질수록 이익률이 좋아지는 게 정상이었습니다. 에이전트는 그 전제를 깨뜨립니다. 사용자가 버튼을 한 번 누르면 모델 호출이 한 번 일어나는 게 아니라, 문서를 찾고 읽고 도구를 부르고 다시 판단하는 과정이 수십 번에서 수백 번 반복되니까요. 제품이 좋아질수록 요청 하나가 더 오래 생각하고, 더 오래 생각할수록 청구서가 커집니다. 소프트웨어 회사의 매출원가가 서버 임대료가 아니라 모델이 생각한 시간으로 채워지기 시작한 것입니다.
▸ 남의 베이스 위에 자기 업무를 얹다 : 1,750개의 법률 업무 환경
하비가 택한 답은 자체 모델이었습니다. 8월 20일 회사 블로그에 하비 테넷(Harvey Tenet)을 리서치 프리뷰로 공개했는데요. 바닥부터 학습시킨 모델이 아니라, 문샷 AI가 공개한 오픈웨이트 모델 Kimi K3를 가져와 파이어웍스(Fireworks) 연구팀과 함께 후학습한 모델입니다. 오픈웨이트 위에 도메인 후학습을 얹는 방식은 예전에 코딩 모델 쪽에서 다룬 적이 있는데요, 이번에는 코딩이 아니라 법률입니다.
방법은 비동기 강화학습이고, GSPO(group-sequence policy optimization)라는 기법을 썼습니다. 토큰 하나하나에 가중치를 매기던 것을 모델이 내놓은 응답 전체를 한 단위로 묶어 매기는 쪽으로 바꾼 방식인데요, 점수를 주는 단위와 학습하는 단위를 맞춰 두면 긴 호흡의 작업에서 학습이 덜 흔들립니다. 도구를 부르고 문서를 찾고 중간 판단을 내리는 일이 수십 번 이어지는 법률 업무가 정확히 그런 작업이고요. 학습에 쓴 것은 약 1,750개의 법률 업무 환경이었고, 하비는 후학습 과정 어디에도 고객 데이터를 쓰지 않았다고 명시했습니다. 합성 데이터와 공개된 법률 데이터, 사람 전문가가 만든 데이터를 썼다고 밝혔고요.
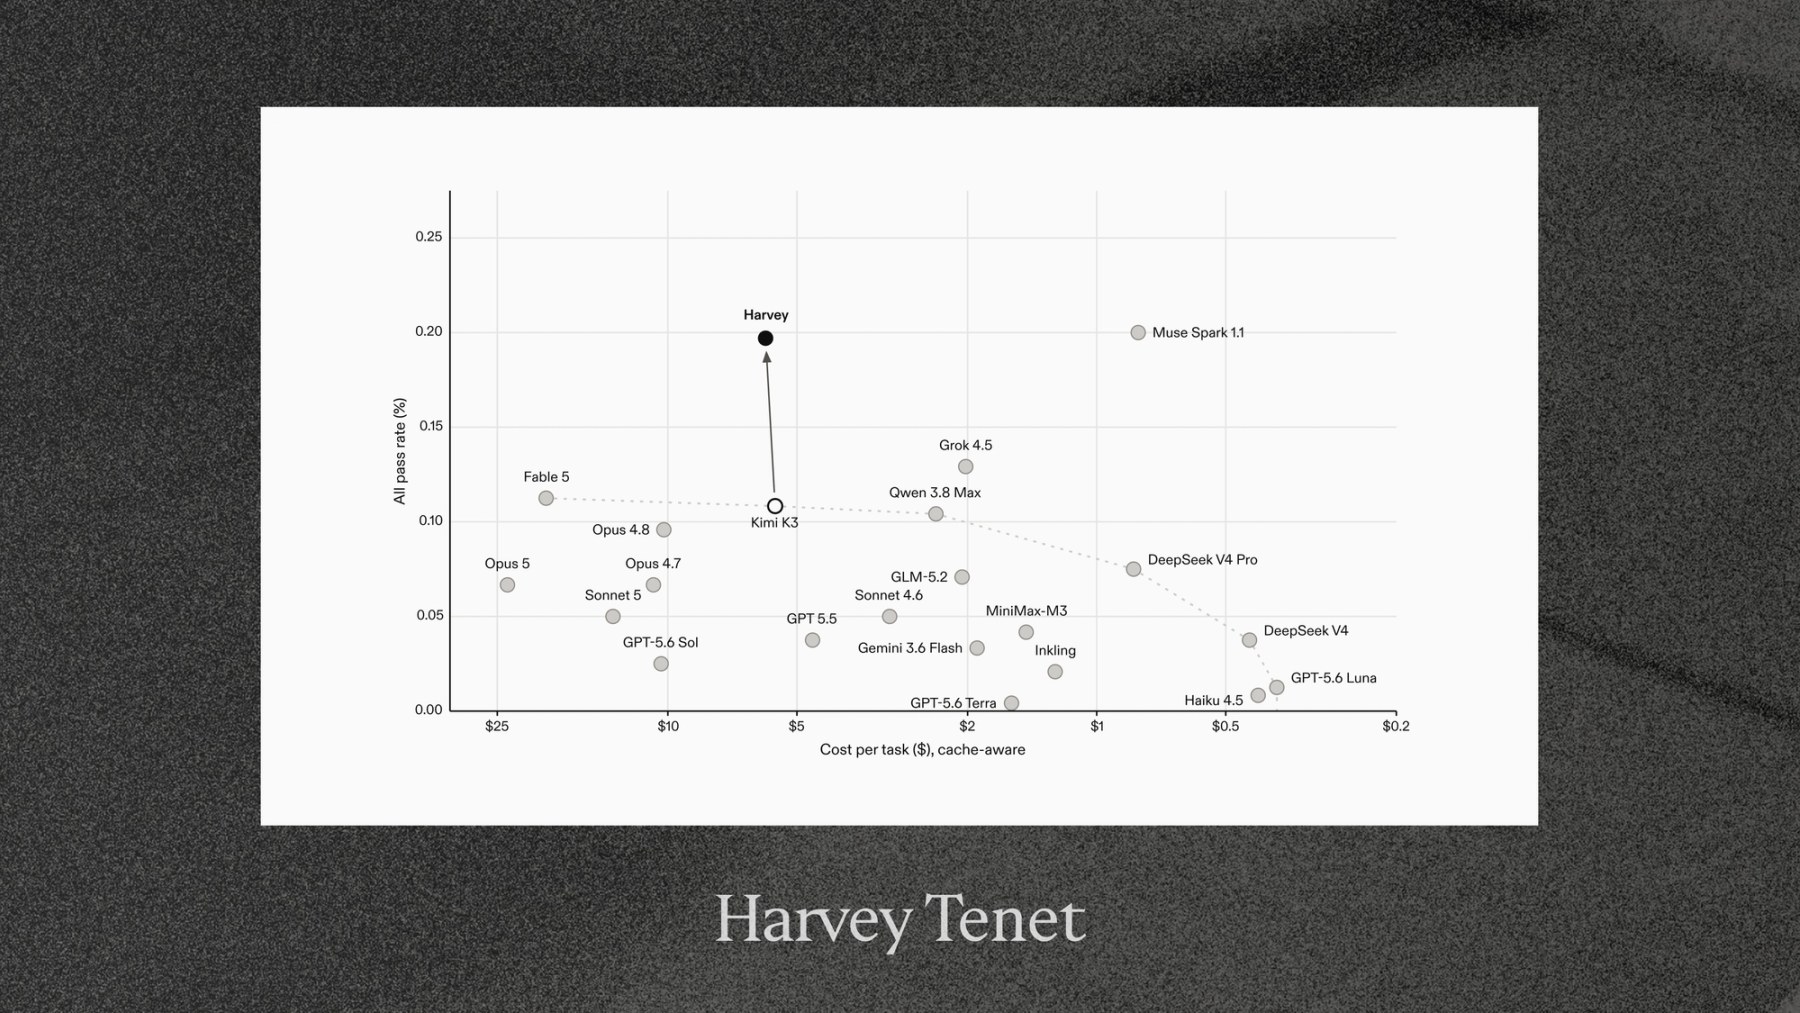
결과는 하비가 자체적으로 만든 벤치마크인 LAB(Legal Agent Benchmark)으로 발표됐습니다. 베이스 모델인 Kimi K3와 비교했을 때 처음 보는 과제를 끝까지 완수한 비율이 거의 두 배였고, 계약서를 다루는 세부 항목인 LAB Contracts에서는 완수한 과제 수가 20% 더 많았습니다.
출처: Harvey
이 그림에서 눈여겨볼 것은 화살표의 방향입니다. 비용을 줄이는 쪽이 아니라 완수율을 올리는 쪽으로 갔어요. 태스크당 비용은 거의 그대로 둔 채 품질만 끌어올렸다는 뜻이죠. 하비는 도구를 효율적으로 쓰도록 보상을 설계해 비용을 붙잡아 두었다고 설명했습니다.
▸ 자기 시험지에서도 1등은 아니었습니다 : 이 그림이 말하지 않는 것
물론 이 그림을 일반적인 모델 성능 비교로 읽으면 안 됩니다. LAB은 하비가 자기 업무를 기준으로 만든 벤치마크이고, 테넷은 그 업무에 맞춰 후학습된 모델이에요. 같은 그림에서 Opus 5나 GPT-5.6 계열, Fable 5 같은 상위 모델이 테넷보다 아래쪽에 찍혀 있다고 해서 그 모델들이 테넷보다 약하다는 뜻은 아닙니다.
덧붙이면 하비도 테넷이 LAB 1위라고 적지 않았습니다. 공식 발표문의 표현은 LAB Contracts에서 최고 성적이고 LAB 전체로는 2위였어요. 실제로 같은 그림의 가장 높은 자리에는 Muse Spark 1.1이 올라가 있는데, 태스크당 비용이 테넷보다 몇 분의 일 수준입니다. 자기가 만든 시험지에서도 1등은 남의 모델이었다는 뜻이죠. 하비가 이 그림을 그대로 공개한 것은 그래서 눈여겨볼 만합니다.
8월에 이익률이 다시 플러스로 돌아섰다는 대목도 그렇습니다. 테넷이 공개된 것이 8월 20일이고 그것도 리서치 프리뷰였으니, 열하루 만에 한 달 치 원가 구조를 뒤집었다고 보기는 어렵습니다. 더 정확한 표현은, 자체 모델이 여러 조치 가운데 하나였다는 쪽이겠죠. 캐시 적중률을 올리고, 쉬운 작업을 값싼 모델로 내려보내고, 계약 조건을 손보는 일은 모델을 바꾸는 것보다 먼저 할 수 있는 일들입니다.
그리고 이것은 프런티어 모델과의 결별이 아닙니다. 블룸버그에 따르면 앤트로픽은 최근 투자자들에게 이 추세를 정리한 자료를 보여 주면서, 하비가 자체 모델을 만든 것은 맞지만 가장 복잡한 작업에는 여전히 Claude Opus 같은 상위 모델이 필요하다는 점을 함께 짚었다고 합니다. 이해관계가 걸린 쪽의 설명이니 감안해서 들어야겠지만, 하비가 내놓은 그림과 어긋나지도 않아요. 그러니 이 사건을 오픈웨이트가 프런티어를 이겼다고 묶는 것은 정확하지 않습니다. 더 정확한 표현은, 애플리케이션을 만드는 쪽이 자기 업무를 난이도별로 나눠 서로 다른 모델에 보내기 시작했다는 것입니다.
▸ 바꿀 수 있는 것과 바꿀 수 없는 것
저는 하비가 진짜로 만든 것이 모델은 아니라고 봅니다. 베이스는 남의 것이고 언제든 갈아 끼울 수 있어요. Kimi K3보다 나은 오픈웨이트가 나오면 그 위에 다시 얹으면 그만입니다. 갈아 끼울 수 없는 쪽은 1,750개의 법률 업무 환경과, 무엇을 잘한 것으로 칠지 정해 둔 보상 설계입니다. 계약서 검토가 끝났다는 것을 무엇으로 판정할지, 어떤 도구를 몇 번 부르는 것이 효율적인지를 정의한 것은 모델이 아니라 하비의 변호사와 엔지니어들이었겠죠. 경쟁 우위가 모델이 아니라 평가 환경 쪽에 쌓이기 시작한 것입니다.
같은 길을 걷는 회사가 하비만은 아닙니다. 의료 기록을 다루는 애브리지(Abridge)는 엔비디아가 공개한 오픈웨이트를 기반으로 임상 모델을 만들겠다고 했고, 고객 응대 에이전트를 만드는 데카곤(Decagon)은 질의의 80%가량을 자체 모델로 처리한다고 밝혔습니다. 6월에 7억 5,000만 달러를 조달한 핀테크 회사 램프(Ramp)는 자체 모델 학습을 처음으로 검토하고 있고요. 램프의 공동 CEO인 카림 아티에는 "1년 전만 해도 전혀 말이 안 됐습니다"라고 했습니다. 지금은 점점 말이 되기 시작했다는 이야기였고요. 벤처캐피털 베이시스 셋의 창업자인 란 쉐자오는 더 단호했습니다. 비용을 최적화하고 자체 모델을 파인튜닝하지 않는다면 정의상 비효율적인 것이라고 했어요.
AI 기능을 붙여 파는 조직이라면 손익계산서보다 먼저 들여다볼 것이 몇 가지 있습니다. 요청 한 건이 아니라 업무 한 건을 끝내는 데 드는 비용, 그 비용의 고객별 분포, 캐시 적중률, 그리고 지금 상위 모델로 보내는 요청 가운데 실제로 상위 모델이 필요한 비율. 이 네 가지를 계측해 두지 않으면 사용량이 늘어난 달에 무슨 일이 있었는지 나중에도 알 수 없습니다.
하비의 사례가 말하는 것은 프런티어 모델을 쓰지 말자는 결론이라기보다, 에이전트를 파는 순간 원가가 제품의 일부가 된다는 사실에 가깝습니다. 그럼에도, 우린 더 오래 생각하게 만들수록 좋아지는 제품과 더 오래 생각할수록 나빠지는 손익 사이에서 갈등하게 됩니다.
커버 이미지: 예일 로스쿨 도서관 열람실 — Wikimedia Commons, PENG Yanan (Neo-Jay)
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →