DeepSeek이 10월 17일 검색(Search) API와 본문 수집(Fetch) API를 외부 개발자에게 열었습니다. 자사 모델을 쓰지 않아도 따로 호출할 수 있습니다. 가격은 둘 다 성공한 요청 1,000건당 0.75달러입니다. 빈 결과나 타임아웃은 과금하지 않고, 결과를 10개 받든 50개 받든 값은 같고요. 다만 DeepSeek Harness나 Claude Code, Codex 안에서 서버사이드로 도는 호출은 11월 1일 베이징 시각 0시부터 과금이 시작됩니다.
비교할 숫자를 옆에 놓아 보죠. Brave가 1,000건에 5달러, Exa가 7달러, Tavily가 8달러쯤 하고, 마이크로소프트의 Grounding with Bing은 14달러입니다(이쪽은 원시 결과가 아니라 모델이 정리한 인용 답변을 주니 같은 상품은 아니고요). 가장 싼 Brave와 견줘도 7분의 1 수준이고, Bing 쪽과는 19분의 1쯤 됩니다.
그런데 이 표를 보고 검색 비용이 10분의 1이 된다고 계산하면, 아마 거의 틀릴 겁니다.
에이전트가 "웹을 검색한다"고 할 때 실제로 청구되는 요금은 두 개거든요. 하나는 방금 본 검색 API 요금이고, 다른 하나는 그 검색 결과를 모델이 읽는 입력 토큰 요금입니다. 그리고 보통은 두 번째가 훨씬 큽니다.
에이전트 한 대를 세워 놓고 따라가 보죠. 질문 1,000개를 처리하는데 질문 하나당 검색을 세 번 돌리고, 한 번에 결과를 열 개씩 받는다고 가정합니다. 검색 호출은 3,000번이니 Brave면 15달러, Exa면 21달러, DeepSeek이면 2.25달러입니다. 여기까지가 가격표에 적힌 비용이에요.
이제 그 결과를 모델에 넣습니다. 각 결과에서 두세 문장짜리 발췌만 가져가면 검색 한 번에 3,750토큰쯤이고, 1,000개 질문이면 1,100만 토큰 남짓입니다. 입력 100만 토큰에 2달러인 모델이라면 22달러죠. 검색 요금과 엇비슷합니다. 그런데 "발췌로는 부정확하니 본문을 통째로 읽혀야 한다"는 판단으로 페이지 전문을 넣기 시작하면, 결과 하나가 5천 토큰쯤 되니 검색 한 번에 5만 토큰, 1,000개 질문이면 1억 5천만 토큰, 300달러가 됩니다. 검색 요금이 많아야 두 자릿수 달러였다는 걸 생각하면 청구서의 주인이 바뀐 겁니다.
여기에 에이전트 특유의 가중이 하나 더 붙습니다. 에이전트 루프는 매 턴마다 이전 툴 결과를 대화에 다시 실어 보내요. 한 번 넣은 본문이 턴 수만큼 다시 청구된다는 뜻입니다. 프롬프트 캐싱이 재읽기 단가를 많이 깎아 주긴 하지만, 깎아 줄 뿐 없애지는 않고요. 더 싼 모델로 갈아타는 것도 생각만큼 통하지 않습니다. 10만 토큰을 넘어가면 장문 구간 단가를 따로 매기는 모델이 많아서, 저가 모델로 같은 워크로드를 돌려도 1,000개 질문에 70~80달러쯤은 나옵니다. 위 표에 있는 어떤 검색 요금보다 큰 금액이죠.
이걸 알고 나서 DeepSeek의 응답 형식을 다시 보면, 가격표보다 흥미로운 게 보입니다.
검색 결과 하나에 요약이 두 개 들어 있어요. snippet은 100~200자로 화면에 보여 주라고 만든 것이고, summary는 600~800자인데 문서에 "모델이 읽는 용"이라고 못 박아 뒀습니다. 페이지 전문에 해당하는 content 필드는 need_content를 true로 켜야만 채워지고, 기본값은 false예요. 본문을 따로 받아 오는 Fetch는 아예 다른 엔드포인트인 데다 호출당 같은 값을 또 받고요.
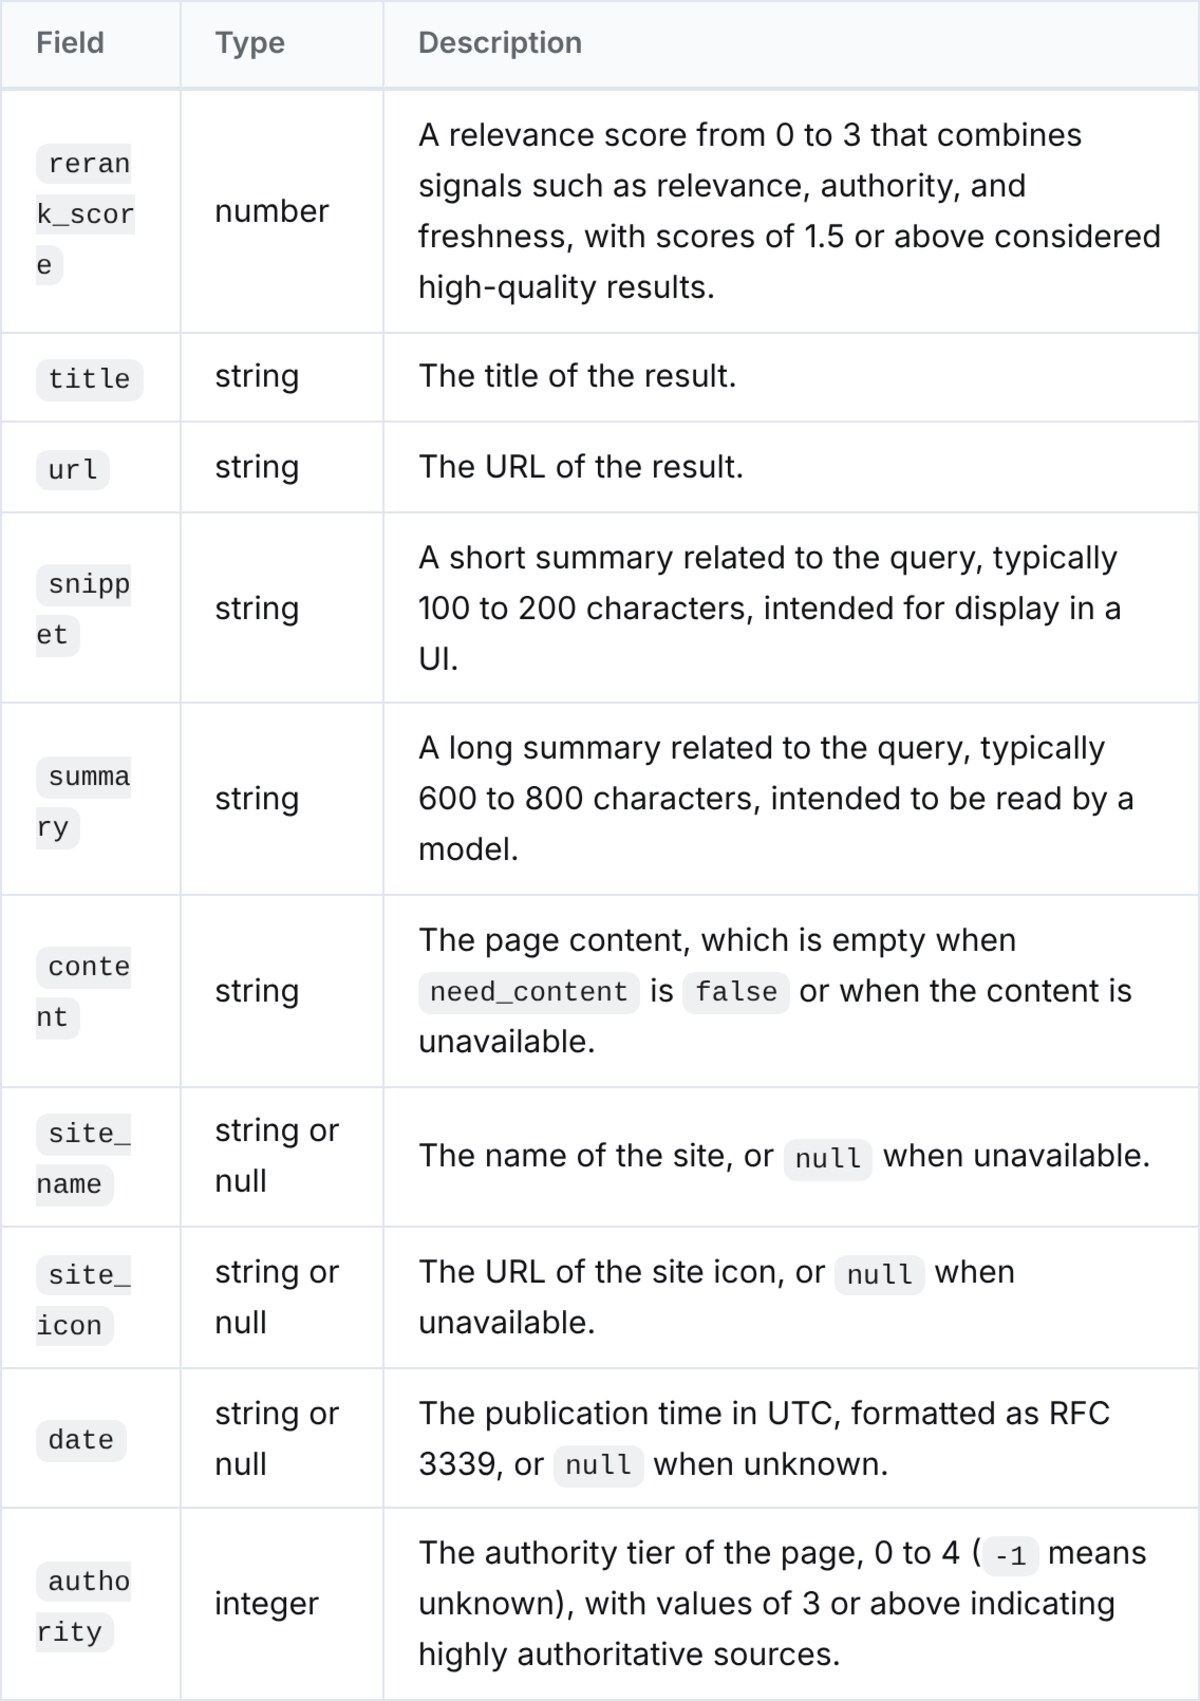
DeepSeek 공식 API 문서의 검색 응답 필드 표. snippet은 "UI 표시용", summary는 "모델이 읽는 용"이라고 쓰여 있고, content는 need_content가 false면 비어 있다고 적혀 있습니다.
출처: DeepSeek API 문서
그러니까 DeepSeek이 설계로 말하고 있는 건 이겁니다. 원문을 열지 마세요, 600~800자면 충분합니다. 검색 요금을 7분의 1로 깎은 것보다, 모델에게 읽힐 분량의 기본값을 자기들이 정해 둔 쪽이 실제 청구서에는 더 크게 작용합니다.
그래서 공급자를 바꾸기 전에 재 볼 것들이 있습니다. 한 과제를 끝내는 데 에이전트가 검색을 몇 번 호출하는지, 결과를 몇 개씩 받고 있는지(DeepSeek 기본값은 10개이고 50개까지 열려 있습니다), 결과의 본문을 컨텍스트에 넣고 있는지 발췌만 넣고 있는지, 그 툴 결과가 턴마다 재전송되는 크기가 얼마인지, 캐싱은 걸려 있는지. 이 다섯 개를 재지 않고 공급자만 바꾸면 줄어드는 쪽은 청구서에서 작은 항목입니다.
조달 쪽에서 하나 더 볼 게 있습니다. 검색 쿼리는 그대로 중국 서버로 갑니다. 게다가 요청 필드에 ori_question이라는 게 있는데, 검색어로 다듬기 전 사용자의 원래 질문을 128자까지 같이 보내라는 선택 항목이에요. 검색어보다 원 질문 쪽이 사내 맥락을 훨씬 많이 담죠. 사내 문서 검색이 아니라 웹 검색이니 괜찮다고 넘기기 전에, 그 질문 문자열에 무엇이 실려 나가는지는 한 번 보고 가는 게 좋겠습니다.
마지막으로 출처에 없는 가정 하나를 적어 두겠습니다. 요약 필드가 충분히 좋아지면, 에이전트가 원문 페이지를 아예 열지 않는 쪽으로 굳을 겁니다. 예측이라기보다 가정인데 근거는 두 가지예요. 문서가 content의 기본값을 꺼 두고 요약 쪽에 "모델용"이라는 이름을 붙여 둔 것, 그리고 Fetch를 별도 과금으로 떼어 둔 것. 요약으로 끝낼 수 있으면 돈도 토큰도 아끼게 되어 있는 구조입니다. 그런데 그 요약을 만들려면 누군가는 원문을 가져와야 하고, 이번 Search·Fetch 문서는 그 수집기가 어떤 User-Agent로 오는지, 어느 IP 대역을 쓰는지, robots.txt를 보는지를 적어 두지 않았습니다. 결과에 붙는 authority 0~4 등급을 누가 어떤 기준으로 매기는지도 마찬가지고요.
검색 요금이 1,000건에 0.75달러까지 내려온 건 에이전트를 만드는 입장에서는 반가운 일입니다. 다만 싸진 덕에 더 자주 검색하게 되고, 그렇게 늘어난 결과가 매 턴 컨텍스트에 다시 쌓인다면, 줄었다고 생각한 돈이 어디서 다시 나가는지는 봐 둬야겠죠. 요금표는 공개돼 있는데 정작 우리 에이전트가 하루에 검색을 몇 번 하는지는 모르는 팀이 꽤 많을 것 같아서, 좀 신경이 쓰이네요.
커버 이미지: 도서관의 카드 색인함 — Wikimedia Commons, mamsy
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →