50.0%와 27.3%. 같은 모델이 같은 발표 자료에서 받은 두 점수입니다.
앞의 숫자는 FrontierCode라는 코딩 벤치마크에서 나왔습니다. 비교 대상인 Fable 5.1이 50.9였으니 1점도 차이가 나지 않지요. 뒤의 숫자는 Terminal-Bench 4에서 나왔는데요. 같은 Fable 5.1이 여기서는 55.8을 받았습니다. 두 배가 넘습니다.
현지 시각 9월 10일, 코그니션(Cognition)이 코딩 모델 SWE-2를 공개했습니다. Devin을 만든 회사인데요. CEO인 스콧 우를 비롯한 초기 열 명이 국제정보올림피아드 금메달을 합쳐 열 개 가지고 있었습니다. 경쟁 프로그래밍 출신들이 세운 회사지요. 발표의 요지는 한 문장으로 정리됩니다. FrontierCode에서 Fable 5.1과 1점 이내로 붙으면서 비용은 64% 낮다는 것이지요. 회사 공식 계정도 "matching Fable 5.1 at 64% lower cost"라고 적었습니다.
그런데 저는 이 발표에서 64%보다 먼저 눈에 들어온 문장이 따로 있었습니다. 베이스 모델에 관한 대목입니다.
SWE-2는 Kimi K3 위에 올린 모델입니다. 문샷 AI(Moonshot AI)가 7월에 공개한 2조 8,000억 파라미터짜리 오픈웨이트지요. (예전에 한 번 다룬 적이 있는데요, 그때 화제는 이 모델을 돌리려면 가속기가 몇 장 필요한가였습니다.) 코그니션은 이렇게 적었습니다. 이미 대규모 강화학습을 거친 2.8조 파라미터 모델에서 출발했는데, 그럼에도 자사의 강화학습이 "많은 벤치마크에서 5~6점을 더하는" 여지를 찾아냈다고요.
*출처: Wikimedia Commons*
▸ 5~6점은 상수였습니다 : 베이스가 못하는 자리에서는 같이 못합니다
5~6점. 이 숫자를 그대로 받아들이면 앞의 두 점수가 설명됩니다.
Kimi K3가 잘하는 자리에서 SWE-2는 잘합니다. 거기에 5점이 붙지요. Kimi K3가 못하는 자리에서 SWE-2는 못합니다. 거기에도 5점이 붙고요. Terminal-Bench 4가 정확히 그런 자리입니다. 그리고 이건 제 추측이 아닙니다. 같은 표에 Kimi K3의 점수가 함께 실려 있거든요. 21.5입니다. SWE-2는 27.3이고요. 5.8점입니다. 앞서 본 FrontierCode에서도 44.2가 50.0이 됐으니 역시 5.8점이고요. SWE-2가 유독 무너진 것이 아니라 원래 그런 모양이었던 것이지요.
후처리가 한 일은 능력의 모양을 바꾼 것이 아니라 높이를 올린 것입니다. 상수를 더했습니다.
이게 왜 중요할까요? 구매를 판단하는 사람 입장에서 근거가 놓인 자리가 달라지기 때문입니다. 발표 자료에 실린 벤치마크 네 개는 여러분의 실무가 아닙니다. 실무는 그 표에 없는 나머지 전부지요. 그 나머지에서 이 모델이 어떻게 움직일지 가늠하려면 무엇을 봐야 할까요? SWE-2의 발표 자료가 아닙니다. Kimi K3의 자료를 봐야 합니다. 오픈웨이트라서 가중치를 받아 확인해 볼 수도 있고요. 물론 앞에서 말한 대로, 그걸 실제로 돌려 보려면 가속기가 한참 필요하지만 말입니다.
판단의 근거가 발표하는 쪽이 아니라 다른 곳에 있는 셈입니다.
▸ 64%에 대응하는 가격표는 없습니다
64%도 한 번 더 들여다볼 필요가 있습니다.
이 숫자는 가격표에서 나온 것이 아니라 작업 하나를 끝내는 데 들어간 비용에서 나왔습니다. 그리고 SWE-2에는 대응하는 가격표가 없습니다. 범용 API로 파는 모델이 아니라 Devin 안에서만 도는 모델이거든요. Devin 문서를 열어 보면 토큰 단가가 적혀 있기는 합니다. 100만 토큰 기준으로 입력 0.75달러, 출력 3.75달러. 그런데 이건 정가인 3달러와 15달러를 75% 깎은 값이고, 크레딧으로 결제하는 기업 고객에게 올해 말까지 적용되는 조건입니다. 그 위에 추론 강도에 따라 크레딧이 6배에서 12배까지 곱해지고요.
그러니까 64%는 제가 지불할 수 있는 할인율이 아닙니다. 모델부터 제품까지 한 회사가 다 쥐고 있는 상태에서 자기 원가를 계산해 내놓은 숫자지요. 틀린 숫자는 아닙니다. 다만 전부는 아닙니다.
절감이 어디서 나왔는지도 짚어 둘 만합니다. 코그니션은 SWE-2 medium이 FrontierCode에서 이전 모델인 SWE-1.7보다 앞서면서 에이전트가 주고받는 횟수는 58% 줄었다고 밝혔습니다. 평균 127회가 53회가 됐고요. 같은 일을 절반 이하의 왕복으로 끝냈다는 뜻인데, 이건 모델이 똑똑해진 결과이기도 하지만 모델을 감싸고 돌리는 바깥 루프가 나아진 결과이기도 합니다. 비용이 줄어든 자리와 모델이 좋아진 자리가 꼭 같지는 않습니다.
▸ 공개된 가중치를 받아, 공개하지 않는 가중치를 내놓았습니다
물론 이것을 과장 광고라고 할 생각은 없습니다.
이미 대규모 강화학습을 거친 2.8조 파라미터 모델 위에서 또 5~6점을 찾아낸 것은 쉬운 일이 아닙니다. 코그니션은 베이스가 강할수록 불완전한 학습 환경에서 지름길을 잘 찾아낸다는 점을 발견하고, 롤아웃을 일일이 들여다보며 채점기를 반복해서 조였다고 밝혔습니다. 주고받는 횟수를 절반 이하로 줄인 것도 실무에서는 바로 체감되는 개선이고요.
물론 감안할 점도 있습니다. 코그니션은 모델과 벤치마크 조합마다 공개된 결과가 있으면 그것을 쓰고, 없으면 자사 평가 프레임워크에서 직접 돌렸다고 밝혔습니다. 돌릴 때는 각 모델이 주로 개발된 하네스를 썼다고 했고요. 나름대로 성실한 방식입니다만, 어느 칸이 어느 쪽인지는 표에 적혀 있지 않습니다. 제3자가 같은 조건으로 재현한 결과도 아직 없고요.
그리고 한 가지 더. SWE-2의 가중치는 공개되지 않았습니다. 공개된 가중치를 받아 공개하지 않는 가중치를 내놓은 셈이지요. 그런데 Kimi K3 쪽도 조건 없이 열려 있는 것은 아닙니다. 문샷 AI가 붙인 라이선스는 모델을 서비스로 파는 사업자가 계열사를 합쳐 12개월 매출 2,000만 달러를 넘으면 별도 계약을 맺도록 하고 있는데요. 대신 모델을 특정 제품의 기능이나 하네스 안에 넣어 쓰는 경우는 그 범주에서 빠집니다. 그리고 SWE-2는 Devin 안에서만 돕니다. 두 사실을 나란히 놓아 두겠습니다.
국내에도 Qwen이나 Kimi, GLM 위에 파인튜닝해서 쓰는 팀이 있습니다. 그 팀들에게 이번 발표는 반가운 소식이면서 동시에 같은 질문을 남깁니다. 우리가 더한 것이 몇 점인지, 그리고 그 점수가 모든 작업에 고르게 붙는 상수인지 아니면 우리가 겨냥한 자리에서만 붙는지. 베이스가 잘하는 것은 우리도 잘하고, 베이스가 못하는 것은 우리도 못합니다. 자랑할 자리와 조심할 자리를 가르는 선이 거기쯤 있겠죠. 성과를 발표할 때 어느 벤치마크를 싣고 어느 벤치마크를 빼는지도 함께 고민이 필요합니다.
---
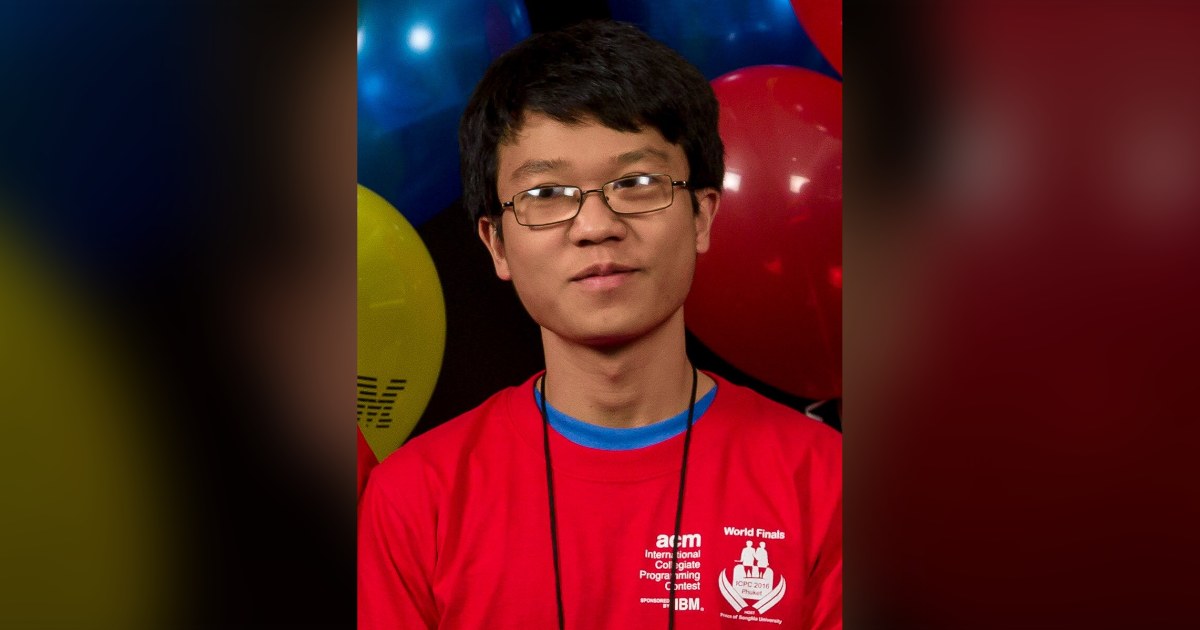
*커버 이미지: 2016년 ACM-ICPC 세계대회의 스콧 우 — Wikimedia Commons, ICPCNews*
전체 사이트에서 댓글·관련 글을 함께 보시려면
이야기 공장에서 보기 →